Ein Benchmark für Sprachmodelle in der Baukalkulation
Die Letzten 10
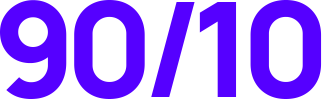
90 % der Kalkulation sind Routine. Die letzten 10 % entscheiden, ob ein Angebot den Zuschlag erhält und sich rechnet. Dieser Benchmark misst, wie gut Sprachmodelle diese letzten 10 % beherrschen.
- DokumenteAusschreibungen, Leistungsverzeichnisse (LV), Baubeschreibungen und Datenblätter auslesen.
- PläneZeichnungen lesen: Trassen, Maße, Symbole und Mengen.
- RechnenDeterministisch rechnen: Füllgrad, Lasten, Mengen und Summen.
- StundenLohnzeiten je LV-Position schätzen.
- KostenEinheitspreise (EP) und Gesamtkosten schätzen.
- DialogMit dem Nutzer arbeiten: Rückfragen stellen, fehlende Angaben benennen.
Version 0.1 · Lauf vom 12. November 2026 · 66 Aufgaben · 1 Durchlauf je Aufgabe
Rangliste
Der Score reicht von 0 bis 100 und ist das Mittel über die sechs Disziplinen. Die Reasoning-Stufe ist die Einstellung des Anbieters (low, medium, high); wir übernehmen seine Bezeichnungen. Zeit und Kosten gelten je Aufgabe, also für einen vollständigen Lauf über mehrere Schritte. Wählen Sie eine Spalte, um zu sortieren.
| # | Modell | Reasoning-Stufe | |||||
|---|---|---|---|---|---|---|---|
| 1 | gpt-6.1-terraopenailow | low | 99,0 | 28 s | 0,022 $ | 4,9 | 48 % |
| 2 | gpt-6.1-terraopenaimedium | medium | 99,0 | 35 s | 0,027 $ | 5,0 | 48 % |
| 3 | gpt-6.1-terraopenaihigh | high | 98,8 | 45 s | 0,031 $ | 4,9 | 46 % |
| 4 | gemini-4-hydrogengooglemedium | medium | 97,4 | 74 s | 0,11 $ | 6,6 | 41 % |
Reasoning-Stufen
Jedes Diagramm zeigt die Reasoning-Stufen eines Modells: Score gegen Kosten je Aufgabe, auf logarithmischer Skala. Die Tabelle darunter ergänzt die Zeit.
| Reasoning-StufeStufe | Score | Kosten je AufgabeKosten | Zeit je AufgabeZeit |
|---|---|---|---|
| low | 99,0 | 0,022 $ | 28 s |
| medium | 99,0 | 0,027 $ | 35 s |
| high | 98,8 | 0,031 $ | 45 s |
| Reasoning-StufeStufe | Score | Kosten je AufgabeKosten | Zeit je AufgabeZeit |
|---|---|---|---|
| medium | 97,4 | 0,11 $ | 74 s |
Disziplinen
Sechs Disziplinen, jede ein Teil der Kalkulation. Wählen Sie eine aus, um ihre Ergebnisse zu sehen.
Dokumente
| Modell | Reasoning-Stufe | Score | Zeit je AufgabeZeit | Kosten je AufgabeKosten |
|---|---|---|---|---|
| gpt-6.1-terraopenailow | low | 100,0 | 38 s | 0,030 $ |
| gpt-6.1-terraopenaimedium | medium | 100,0 | 38 s | 0,031 $ |
| gpt-6.1-terraopenaihigh | high | 100,0 | 41 s | 0,032 $ |
| gemini-4-hydrogengooglemedium | medium | 100,0 | 68 s | 0,10 $ |
Nach Sprache
Jede Aufgabe läuft auf Deutsch und auf Englisch, mit denselben Daten, Vorgaben und Bewertungen.
| Modell | Reasoning-Stufe | Deutsch | Englisch | Differenz |
|---|---|---|---|---|
| gpt-6.1-terraopenailow | low | 99,0 | 99,0 | +0,0 |
| gpt-6.1-terraopenaimedium | medium | 99,0 | 98,9 | +0,2 |
| gpt-6.1-terraopenaihigh | high | 98,5 | 99,2 | −0,7 |
| gemini-4-hydrogengooglemedium | medium | 98,6 | 96,2 | +2,4 |
Methode
- Mehrstufig: Jede Aufgabe beginnt mit einer kurzen Vorgabe. Das Modell erreicht die Daten nur über Werkzeuge und reicht am Ende eine Antwort ein.
- Synthetische Referenz: Die Aufgaben sind erzeugt, die richtige Antwort steht also von vornherein fest.
- Scores sind Mittelwerte über die Aufgaben, jede Aufgabe zählt gleich. Der Gesamtscore ist das Mittel über die Disziplinen.
- Die Kosten sind der Betrag, den OpenRouter abgerechnet hat, einschließlich Lese- und Schreibzugriffen auf den Cache.
- Die Zeit ist die tatsächlich verstrichene Zeit einer vollständigen Aufgabe, vom ersten Modellaufruf bis zur Antwort.
- Datum des Laufs
- 12. November 2026
- Aufgaben
- 66
- Durchläufe je Aufgabe
- 1
- Modelle und Reasoning-Stufen
- 4